트래픽이 몰릴 때 이 순서대로 확인해요 | SaaS 4종 운영 대응 3단계
이벤트나 프로모션으로 트래픽이 갑자기 몰리면 서비스는 늘 비슷한 순서로 무너져요. 자체 SaaS 4종(D:VALUEUP·Likepro·Globing·Linkmix)을 함께 운영하며 정리한 신호 확인·사전 준비·사후 점검, 3단계 대응 원칙을 담았어요.

이벤트나 프로모션으로 사용자가 갑자기 몰리면 서비스는 대체로 같은 순서로 무너져요. 화면이 느려지고, 일부 요청이 실패하고, 그다음에야 완전히 멈추는 식이에요. 저희는 자체 SaaS 4종(D:VALUEUP·Likepro·Globing·Linkmix)을 함께 운영하며 이 순서를 여러 번 지켜봤고, 그래서 트래픽이 몰릴 조짐이 보이면 확인하는 순서를 미리 정해뒀어요. 그 순서와 이벤트를 앞두고 미리 준비해두는 것들을 정리했어요.
“트래픽이 늘면 좋은 거 아닌가요?”라는 말을 들으면 저희는 반쯤만 동의해요. 몰려온 사용자가 서비스를 제대로 써보지도 못하고 이탈하면, 늘어난 숫자는 그래프에만 남고 실제 이용으로는 이어지지 않거든요.
1. 트래픽이 몰리면 왜 항상 같은 순서로 무너질까요
서비스가 한 번에 완전히 멈추는 경우는 드물어요. 먼저 응답이 평소보다 느려지고, 그중에서도 가장 무거운 기능부터 타임아웃이 나기 시작하고, 그게 쌓이면 그제야 전체가 버벅여요. 저희가 4개 서비스를 운영하면서 겪은 장애도 거의 다 이 순서를 따랐어요. 이 단계를 알아두면 “아직 느려지는 정도”인지 “곧 멈출 신호”인지를 구분할 수 있어요. 구분이 안 되면 대응은 항상 한 박자 늦어요.
2. 저희가 가장 먼저 보는 신호 3가지
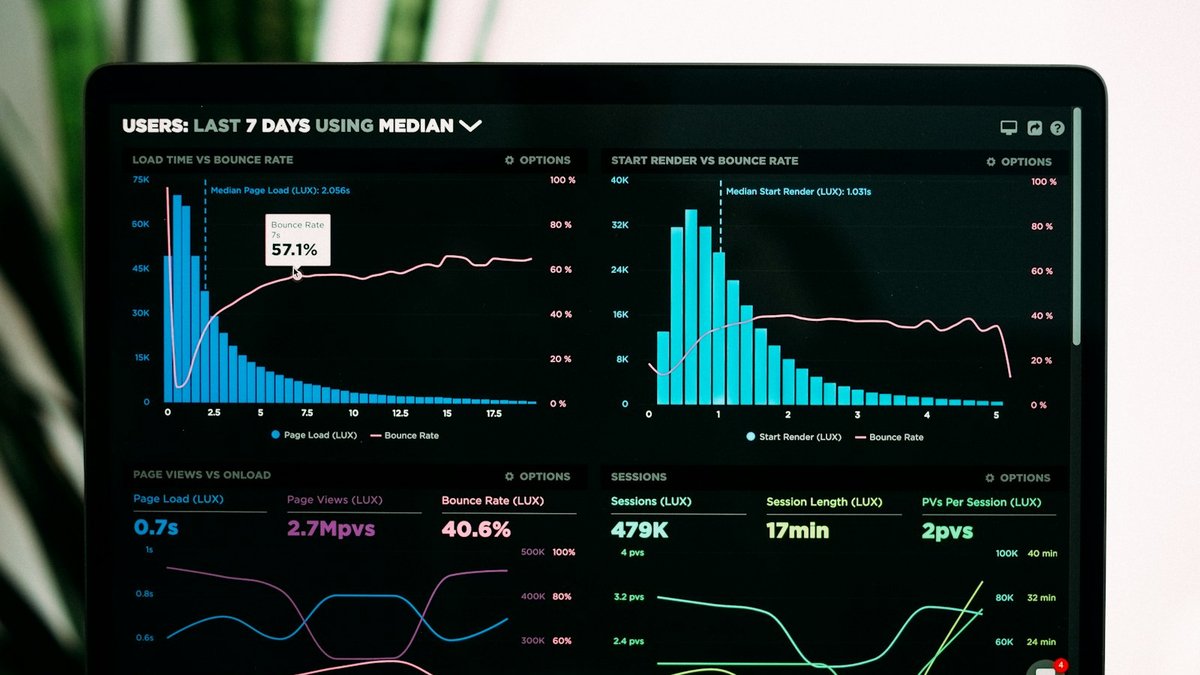
특정 숫자를 외우기보다 평소 범위를 벗어났는지를 봐요. 가장 먼저 잡히는 신호는 응답 시간이에요 — 평소보다 확실히 느려지는 구간이 생기는 순간이요. 그다음은 오류 비율인데, 요청이 실패로 끝나는 비중이 평소 범위를 벗어나면 이미 일부 사용자는 불편을 겪고 있다는 뜻이에요. 마지막으로 대기·처리 지연도 살펴봐요. 큐에 쌓인 작업이나 처리 대기가 늘어나는 건 지금 들어오는 양을 처리 능력이 못 따라가고 있다는 신호거든요. 셋 중 하나만 벗어나도 확인에 들어가고, 두 개 이상 겹치면 우선순위를 올려요.
3. 신호가 잡히면 이 순서로 확인해요
신호를 확인했다고 바로 자원부터 늘리지 않아요. 먼저 영향 범위를 봐요 — 특정 기능만 느려졌는지, 서비스 전체가 그런지에 따라 원인 후보가 완전히 달라져요. 그다음 병목 지점을 좁혀요. 데이터베이스인지, 특정 API인지, 외부 연동(결제·알림 등)인지에 따라 손대야 할 곳이 달라지거든요. 마지막으로 정상 트래픽인지를 확인해요. 실제 사용자가 몰린 건지, 봇이나 반복 요청 때문인지에 따라 대응이 정반대가 될 수 있어요. 이 순서를 건너뛰고 자원부터 늘리면, 엉뚱한 곳을 키우고 정작 병목은 그대로 남는 경우를 여러 번 봤어요.
4. 이벤트를 앞두고 있다면 미리 준비해두는 것들
트래픽이 몰릴 시점을 미리 안다면 손댈 수 있는 부분이 훨씬 많아져요. 자주 조회되는 데이터는 캐싱으로 DB 부담을 줄여두고, 무거운 쿼리는 미리 찾아 손봐둬요. 한 번에 요청이 몰려도 순서대로 처리되도록 대기열이나 요청 제한을 걸어두고, 실제로 그만큼의 부하를 흉내 내는 사전 테스트로 어디서부터 느려지는지 미리 확인해요. 그리고 문제가 생기면 바로 이전 상태로 되돌릴 수 있도록 배포 방식을 준비해둬요. 서버 자원을 넉넉히 두는 건 이 준비들 다음에 오는 마지막 카드예요.
5. 예고된 트래픽과 예고 없는 트래픽은 다르게 대응해요
프로모션처럼 시점을 아는 트래픽은 앞서 다룬 것처럼 미리 준비할 시간이 있어요. 반대로 갑자기 화제가 되면서 예고 없이 몰리는 트래픽은 준비할 틈이 없으니 감지 속도와 상황 판단이 전부예요. 이럴 땐 모든 기능을 다 살리려 하지 않아요. 핵심 기능부터 지키고, 덜 급한 기능은 잠깐 느려지거나 멈추더라도 감수해요. 전체가 함께 무너지는 것보다 핵심만이라도 버티는 편이 사용자 입장에서 체감이 훨씬 덜해요. 트래픽 대응을 이렇게 좁혀서 다뤘는데, 장애 전반을 어떻게 감지하고 복구 순서를 정하는지는 SaaS 4종 운영하며 배운 장애 대응 3원칙에서 더 폭넓게 정리해뒀어요.
서비스를 운영하다 보면 트래픽 대응 체계가 처음부터 잘 갖춰진 시스템은 많지 않아요. 지금 운영 중인 시스템에 이런 대비가 되어 있는지 점검이 필요하시거나, 이벤트를 앞두고 미리 준비하고 싶으시다면 편하게 상담받아보세요. 트래픽 대응 체계 상담받기 →
6. “운영해본 회사”만 보이는 것 — 외주 프로젝트 설계에 반영하는 지점
납품하고 끝나는 프로젝트에서는 트래픽 대응 체계가 설계 단계에서 빠지기 쉬워요. 오픈 당일 트래픽을 실제로 겪어보는 쪽은 만든 개발사가 아니라 운영하는 발주사거든요. 저희는 자체 서비스에서 이 순서로 여러 번 대응해봤기 때문에, 외주 프로젝트를 설계할 때도 “오픈 직후나 이벤트 시점에 트래픽이 얼마나 몰릴 것으로 예상하는지”를 먼저 물어봐요. 이 질문에 대한 답이 있어야 캐싱·대기열 같은 구조를 설계 단계에서 넣을지, 나중에 필요할 때 붙일 수 있게만 열어둘지를 정할 수 있어요. 서버·인프라 비용을 계약 전에 정리해두는 것도 같은 맥락인데, 이 부분은 개발 외주 서버·인프라 비용, 누가 얼마나 낼까요에서 따로 다뤘어요.
7. 자주 묻는 질문
트래픽이 몰릴 걸 미리 알 수 없을 때는 어떻게 대응하나요?
예고 없는 급증은 사전 준비보다 감지 속도가 더 중요해요. 평소 지표 범위를 알고 있어야 ‘평소와 다르다’를 빠르게 알아챌 수 있고, 그래야 원인을 좁히는 시간을 줄일 수 있어요.
트래픽이 늘면 서버 자원부터 늘리면 되지 않나요?
자원 확장은 저희가 가장 마지막에 쓰는 수단이에요. 병목이 처리량이 아니라 특정 쿼리나 외부 연동 지연이면 자원만 늘려서는 안 풀리고 비용만 늘어요. 원인을 먼저 좁히고 나서 어디를 늘릴지 정해요.
작은 규모의 서비스도 이런 준비가 필요할까요?
오히려 규모가 작을수록 여유 자원이 적어서 트래픽 증가에 더 빨리 흔들려요. 큰 체계를 갖추지 않아도 어떤 지표를 보고 누가 먼저 확인할지만 정해둬도 대응 속도가 확실히 달라져요.
8. 마무리 — 트래픽은 기회이자 시험대예요
트래픽이 몰리는 순간은 서비스를 알릴 좋은 기회이면서 동시에 그동안의 준비를 시험받는 순간이기도 해요. 신호를 놓치지 않고, 확인하는 순서를 지키고, 예고된 트래픽과 예고 없는 트래픽을 다르게 다루는 것. 저희가 자체 SaaS 4종을 10년 이상 직접 운영하며 반복해서 확인한 것도 결국 이 세 가지였어요. 50개가 넘는 프로젝트를 진행하면서 롯데·캐논 같은 곳과도 함께 일해 왔고, 그 과정에서 쌓은 감각을 외주 프로젝트를 설계할 때도 그대로 가져가요. 이벤트를 앞두고 있거나 트래픽 대응 체계를 미리 점검하고 싶으시다면 편하게 문의해주세요.
관련해서 함께 보면 좋은 글이에요. SaaS 4종 운영하며 배운 장애 대응 3원칙도 참고해보세요.